Bonjour, je suis Lenny. Chaque semaine, je partage des produits, des conseils de croissance et de carrière profondément étudiés. Pour plus d’informations: Emplois de Lenny , Lennybot , Devenez un constructeur de l’IA-Native et autres favoris Cours d ‘ AI/PM
P.S. Obtenez une année complète gratuite de Curseur, Notion, Lovable, Replit, Flux Wispr, linéaire, L’usine, OnzeLabs, PostHog, Granola, Brain.fm, Waking Up, et plus encore, en devenant un abonné Insider (alors que les fournitures durent). En savoir plus– Oui.
Evals est de plus en plus présent dans mes conversations avec les invités et les PM podcast. Et près de la moitié des 25 heures géniales Les offres d’emploi que j’ai partagées sur les réseaux sociaux la semaine dernière demandent l’expérience de rédaction d’évals. Cette compétence ne fait que gagner en valeur. Alors j’ai demandé Hamel et Shroya pour écrire une suite avancée à leur très populaire -Construire des systèmes d’éval qui améliorent votre produit AI poste de l’année dernière. En s’inspirant de leur travail avec plus de 50 entreprises d’IA, ils ont remarqué que la plupart des équipes sautent directement à l’écriture de mesures – et finissent par mesurer les mauvaises choses. Ci-dessous, ils partagent la partie critique du processus la plupart des équipes sautent, quelles étapes vous pouvez (et ne pouvez pas) automatiser, et un plugin gratuit qui permet à un agent de codage faire la plupart des lourdes levages pour vous. Bonne journée !
Pour aller plus loin, rejoignez leur prochain Cours d’AI Evals pour ingénieurs et PM et utilisez le code de réduction LENNYSLIST à la caisse pour obtenir 25% de réduction.
Vous avez probablement entendu dire que les évaluations sont une compétence déterminante pour les PM d’IA. Mike Krieger, Anthropique ancien CPO et maintenant chef de Labs, a dit que -si il ya une chose que nous pouvons enseigner aux gens de produits, il , il , que l’écriture des evals est maintenant probablement la chose la plus importante. Garry Tan, le PDG de Y Combinator, a partagé que -Evals sont émergeant comme le véritable douve pour les startups d’IA. Un certain nombre d’invités sur Lenny , Podcast ont fait valoir que , , sont les nouveaux PRD , , et de plus en plus , les entreprises de premier plan ont parlé de comment investir dans les evals a payé:
-
Magasiner a utilisé des valeurs pour guider le développement d’un constructeur de workflow AI qui était 2,2 fois plus rapide et 68 % moins cher que le système de modèle frontière qu’il a remplacé.
-
Curseur a développé sa performance de routage Auto Balance avec des valeurs, ce qui a permis d’accroître la satisfaction des utilisateurs tout en réduisant les coûts de 41 %.
-
Ramp a augmenté sa précision de trouver une transaction correspondante dans les photos de réception en utilisant des modèles sur appareil de 35 % à 83 % après avoir investi dans des évaluations.
-
Harvey rebâti son examen de contrat AI avec des valeurs, presque doubler le produit , score de qualité interne.
Rippling, Glân, Abridge, Onze laboratoireset La virilité ont également partagé comment ils ont utilisé des valeurs pour rendre systématiquement leurs produits d’IA mieux.
Les produits d’IA sont faciles à modifier mais difficiles à prévoir. Un changement de code, de modèle ou d’invite peut améliorer un comportement tout en en brisant un autre. Evals transformer votre jugement sur ce que -good-de-good-de-sheet ressemble en tests répétables votre équipe peut courir avant l’expédition. Les erreurs de production signalées par les valeurs peuvent devenir des cas de test supplémentaires qui améliorent votre AI, créant un avantage qui se compose au fil du temps.
Et maintenant que l’IA peut produire des changements plus rapidement que les gens peuvent les examiner, les évaluations aident les équipes à expédier rapidement en vérifiant automatiquement si un produit fonctionne toujours comme prévu.
Dans notre poste antérieur, nous avons défini le processus complet pour construire des évaluations : découvrir et analyser les erreurs, créer des mesures personnalisées et mettre en place une boucle d’amélioration continue. Malheureusement, nous avons constaté que la plupart des équipes sautent la première étape de la découverte d’erreurs et sautent directement à l’écriture de mesures.
Il est facile de voir pourquoi. En regardant les longs enregistrements de sessions utilisateur pour trouver des échecs, on sent lent et difficile à évaluer, alors que les mesures sont concrètes et faciles à automatiser. Mais si vous écrivez des mesures trop tôt, vous finirez par faire trop d’hypothèses sur ce qui est important — et potentiellement mesurer la mauvaise chose, ou la bonne chose mal.
C’est pourquoi la découverte d’erreurs est l’équivalent de la découverte de produits. Tout comme la découverte de produits montre quels problèmes méritent d’être résolus, la découverte d’erreurs révèle quels défauts d’IA méritent d’être mesurés. Sans cela, les équipes risquent de construire des tableaux de bord autour de mesures génériques qui perdent du temps et orientent le produit vers les mauvais résultats.
Nous croyons que la découverte d’erreurs est si importante que si vous n’avez que le temps pour une partie du processus d’évaluation, vous devriez la prioriser.
Dans ce post, nous allons vous montrer les trois étapes pour lancer une découverte d’erreur efficace avec un agent de codage comme Codex ou Claude. Nous avons utilisé ce processus avec plus de 50 entreprises, et chaque fois que les outils ont découvert les défauts majeurs de produit qui étaient en train de nuire à l’expérience client. Ce workflow complet ne prend qu’environ 30 minutes à terminer une fois que vous apprenez les bases.
Remarque : La découverte d’erreurs a beaucoup changé depuis notre dernier post. Notre post précédent a appelé ce processus — analyse d’erreur. Nous l’appelons maintenant la découverte d’erreur, , parce que l’objectif est d’identifier les échecs qui valent la peine d’être mesurés. Continuez à lire pour en apprendre davantage sur la nouvelle approche.
Lorsque vous construisez un produit AI, vous avez besoin d’évals pour comprendre où il fait des erreurs. Mais le maintien des évaluations coûte du temps et de l’argent ; il n’a pas de sens de tout mesurer. La bonne découverte d’erreur identifie les défaillances qui méritent d’être mesurées et suivies au fil du temps. Même lorsque vous savez que vous avez besoin de la phase de découverte d’erreur, il peut être tentant de commencer par remettre à un agent un dossier de traces — des enregistrements complets des sessions d’utilisateur avec votre produit AI — et lui demander de trouver des problèmes. Les agents sont souvent plus rapides que les humains à repérer des problèmes évidents et peuvent trouver des modèles que nous pourrions manquer. Mais ils sont beaucoup moins fiables lorsqu’un échec dépend de votre définition d’une bonne expérience de produit. Vous pouvez expliquer ces normes à l’agent, mais vous ne les découvrez souvent qu’en examinant les données. Ce processus, où l’examen des exemples change votre définition de bien, s’appelle Dérivation des critères– Oui.
Par exemple, ci-dessous est une interaction de Chef de l’horticulture, un assistant de location AI avec lequel nous avons travaillé qui aide les gestionnaires immobiliers à gérer les conversations avec les locataires éventuels:
Perspectives : – C’est hors de mon budget. Merci pour votre entreprise.
Assistant à la location : Bienvenue ! Si votre situation change ou si vous avez d’autres questions à l’avenir, n’hésitez pas à vous adresser à vous. Bonne journée !
La conversation complète de cette interaction est présentée ci-dessous dans la discussion sur les traces.
Pour la plupart des agents, cela ressemble à un succès ; ils n’identifieraient pas une erreur dans cette trace. Mais le but du produit est de faciliter les ventes, ce qui inclut de trouver les bons matches de propriété pour les perspectives. Dans ce cas, l’agent aurait dû explorer des unités moins chères ou d’autres biens appartenant à la même entreprise et offrir des solutions de rechange.
Si nous avons invité l’agent à rechercher cette défaillance de la manipulation d’Objection – – lorsque nous lui avons donné des traces à vérifier, l’agent aurait attrapé l’erreur automatiquement. Mais nous ne savons que d’ajouter –manutention d’objection – à nos critères après voir cette trace nous-mêmes. C’est un cas classique de dérive des critères – et pourquoi il est essentiel de faire un pas en arrière pour examiner les échecs et définir le succès avant d’envoyer un agent pour trouver des erreurs dans une pile de traces.
Dans une étude plus largeNous avons utilisé des outils d’évaluation automatisés et des agents de codage contre 100 traces de production de ce même assistant de location d’appartements. Nous avons trouvé ce qui suit :
-
Agents non-complètes qui exigent un jugement sur le produit et contexte en dehors de la trace, comme le formatage Markdown dans les messages texte et les remises de fonds manquantes (en plus du traitement des objections).
-
Les agents sont bons pour attraper les échecs qui sont évidents à l’intérieur d’une trace, comme des réponses qui sont contredites par la sortie d’outil.
-
Les agents trouvent aussi des problèmes que les humains manquent, mais ils introduisent le bruit en faisant de bonnes réponses comme des échecs.
Il est clair que les approches automatisées sont encore utiles pour trouver certains types d’erreurs, et elles fonctionnent particulièrement bien en conjonction avec le jugement humain. Alors, comment bénéficier d’une automatisation d’agent tout en gardant un humain dans la boucle ? La réponse est un processus qui s’appuie sur apprentissage actif, une méthode pour choisir les exemples les plus informatifs à examiner, étant donné le temps limité. Commencez par un échantillon diversifié de traces afin que vous couvriez la gamme de vos données. Lorsque vous trouvez un échec, regardez quelques autres exemples avant de décider que vous le comprenez. Après avoir examiné suffisamment d’exemples, laissez l’agent annoter des traces que vous pouvez ensuite accepter ou rejeter.
Toute cette tenue de livres et cet échantillonnage seraient difficiles à faire manuellement. Mais les agents de codage sont super. Le reste de ce post vous permet de travailler avec un agent pour faire une découverte d’erreur significative étape par étape, avec l’aide d’un plugin compétences d’évaluation Nous nous sommes préparés pour vous.
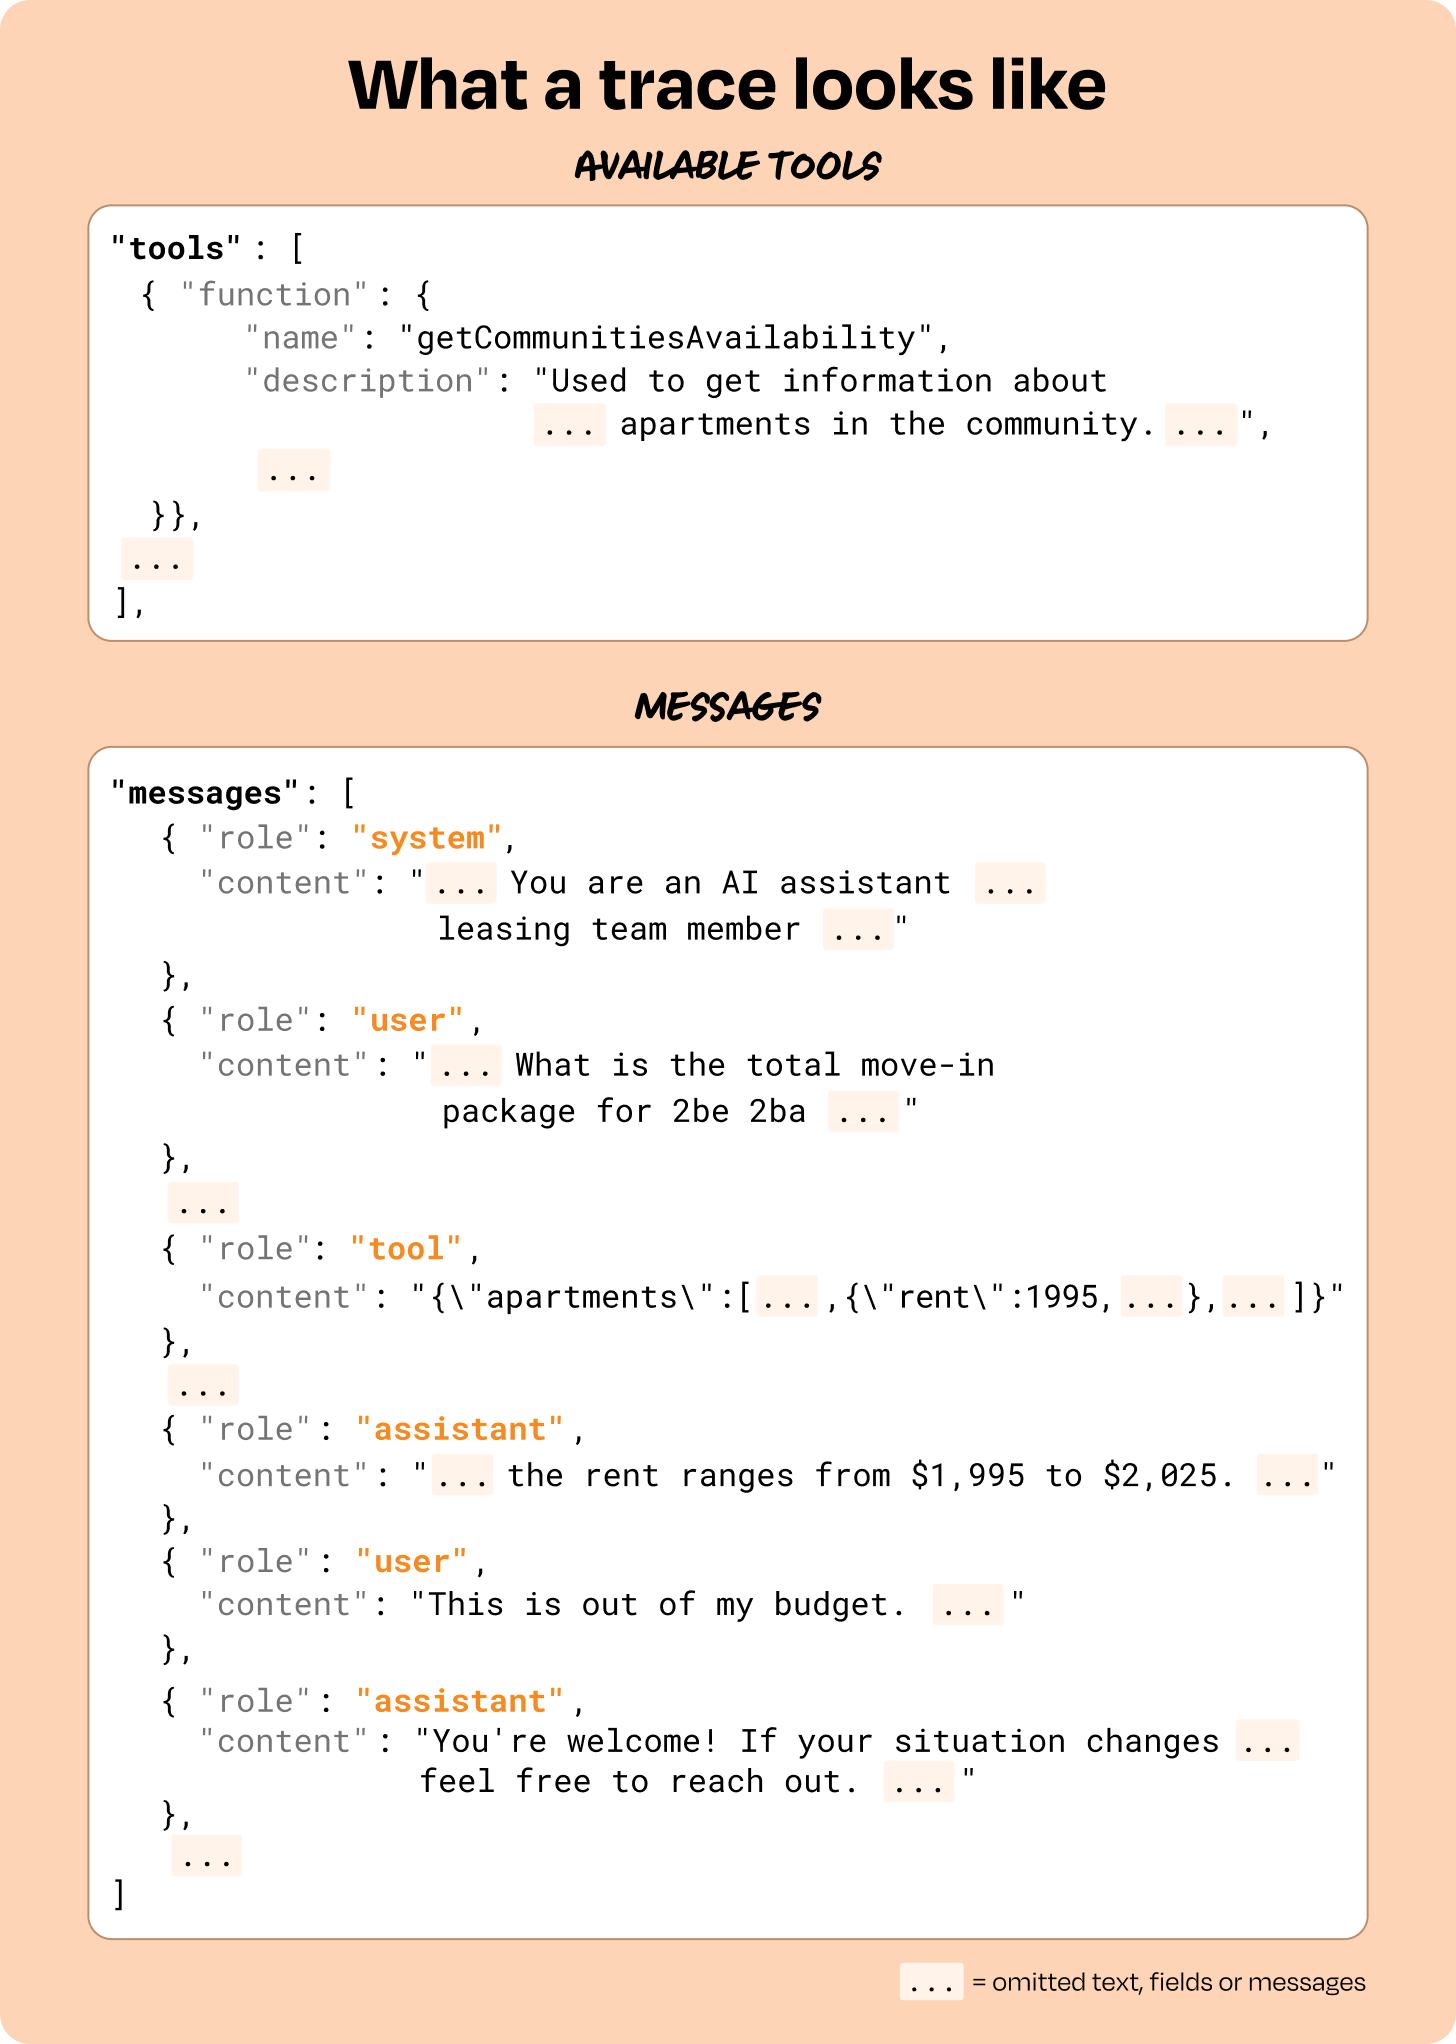
La découverte d’erreurs nécessite des traces. Chaque trace se compose de l’entrée user , de l’invite système, quel que soit le système entre (retrieval, appels d’outils, appels de modèles intermédiaires) et la sortie finale du produit. Chaque trace devrait contenir suffisamment d’information pour qu’un examinateur puisse reconstituer ce qui s’est passé et décider si elle était bonne. Vous pouvez choisir de enregistrer ces données dans une base de données, un fournisseur d’évaluation ou même un dossier local. Pour ce post, nous allons assumer un dossier local pour la simplicité.
Voici à quoi ressemble une trace pour l’assistant de location. Notez que c’est ce à quoi il ressemble dans sa forme brute, et vous voulez généralement le rendre lisible par l’homme (nous y arriverons plus tard):
Si vous n’avez pas de traces, vous pouvez demander à votre agent de codage d’instrumenter votre application afin qu’il enregistre ces données. Voici à quoi pourrait ressembler un prompt pour cela:
Instrumentez cette application pour que chaque session utilisateur avec l’IA soit enregistrée comme une trace complète.
Une trace est une session utilisateur. Inclure l’entrée utilisateur, l’invite système, chaque appel d’outils et son résultat, tout contexte récupéré, chaque appel de modèle intermédiaire et la sortie finale orientée vers l’utilisateur.
Si cette application envoie déjà des traces à un fournisseur (LangSmith, Arize, Phoenix, Langfuse, ou similaire), continuez à utiliser cela. Ecrivez également une copie locale : un objet JSON par session, annexé à traces/traces.jsonl. S’il n’y a pas de fournisseur, le fichier JSONL suffit.
Une fois votre produit instrumenté, vous devrez attendre l’activité de l’utilisateur pour collecter des traces. Si vous n’avez pas encore lancé, vous pouvez essayer de générer des traces synthétiques en simulant les requêtes utilisateur avec un LLM. Bien que les données synthétiques ne puissent remplacer les données réelles, elles sont parfois meilleures que rien.
Une façon efficace de simuler les requêtes des utilisateurs est de définir un petit nombre de dimensions que vous anticipez votre produit pourrait échouer. Par exemple, les dimensions de l’assistant de location pourraient être la tâche (planifier une visite, demander des prix, demander des renseignements sur la politique relative aux animaux de compagnie), le type de personne qui demande, et si la demande était claire, ambiguë ou hors de portée. Puis, demandez au modèle d’utiliser ces dimensions et de transformer chaque combinaison en une requête utilisateur en langage naturel. L’utilisation de dimensions comme celle-ci aide à détourner l’IA de la production de sorties homogènes.
Une fois que vous avez défini les dimensions, votre agent de codage peut combiner leurs valeurs en scénarios. Chaque scénario contient une valeur de chaque dimension. L’agent peut alors faire un appel de modèle séparé pour chaque scénario. Voici un exemple d’invite qui générera des données synthétiques avec cette approche:
Créez un script qui génère des requêtes utilisateur synthétiques pour un assistant de location AI. Utiliser les dimensions et les valeurs ci-dessous comme entrées fixes. Ne les ajoutez pas ou ne les modifiez pas.
Tâche : planifier une visite, demander sur le prix, demander sur la politique de l’animal de compagnie
Loueur: première fois locataire, déménagement famille, étudiant
Type de demande: clair, ambigu, hors de portée
Créer une liste structurée de scénarios d’essai en combinant une valeur de chaque dimension. Faites un tour dans les scénarios et faites un appel de modèle séparé pour chacun. Passez un seul scénario dans chaque appel. Appliquer un schéma de sortie structuré avec un seul querie utilisateur champ, puis enregistrer la requête à côté de son scénario dans questions synthétiques.jsonl.
L’invite ci-dessus recommande un modèle distinct pour chaque scénario parce que nous avons constaté que demander à un agent de tirer un coup a tendance à produire moins de diversité. Voici un exemple de ce que pourrait ressembler une requête utilisateur synthétique:
{ .user query , nous avons deux chiens et nous allons peut-être déménager le mois prochain. Ça marcherait ?
Après avoir produit des données synthétiques, examiner les exemples et supprimer tout ce qui est irréaliste. Si vous remarquez des scénarios que vos dimensions ne couvrent pas, mettez à jour les dimensions et générer de nouveaux exemples couvrant ces lacunes.
La production de données synthétiques de haute qualité (surtout pour les conversations complexes et multi-tours) dépasse le cadre de ce post. Nous recommandons d’obtenir de vrais utilisateurs au lieu de s’appuyer sur des données synthétiques lorsque c’est possible. Si vous devez utiliser des données synthétiques, nous avons une compétence qui peut vous aider avec cela dans l’annexe.
Maintenant nous sommes prêts à trouver des erreurs dans votre produit! Nous avons construit un plugin d’évaluations pour vous guider dans ce processus, basé sur ce que nous avons appris enseignement plus de 4 500 PM et ingénieurs en AI et consultation auprès de plus de 50 entreprises. Installez-le avec npx compétences– Oui.
ajouter des compétences npx https://github.com/ai-evals-course/evals-skills
Ensuite, pointez votre agent de codage à la /vales-compétence de démarrage ou indiquez où sont vos données:
-Utilisez l’habileté de démarrage des évaluations. Mes traces sont dans traces/traces.jsonl et je veux trouver des problèmes qui se produisent dans mon produit AI.
début des évaluations est le point d’entrée pour le plugin compétences d’évals. Il examine votre situation et vous envoie au bon workflow. Dans notre cas, nous avons des traces que nous n’avons pas encore analysées, donc il nous dirigera vers erreur-découverte– Oui.
La première chose erreur-découverte lisez un échantillon de vos dossiers pour apprendre leur schéma. Ensuite, il crée une petite application de révision personnalisée pour vos données et vous les sert localement. Voici un exemple de l’interface de l’application que le plugin créé pour l’assistant de location trace:
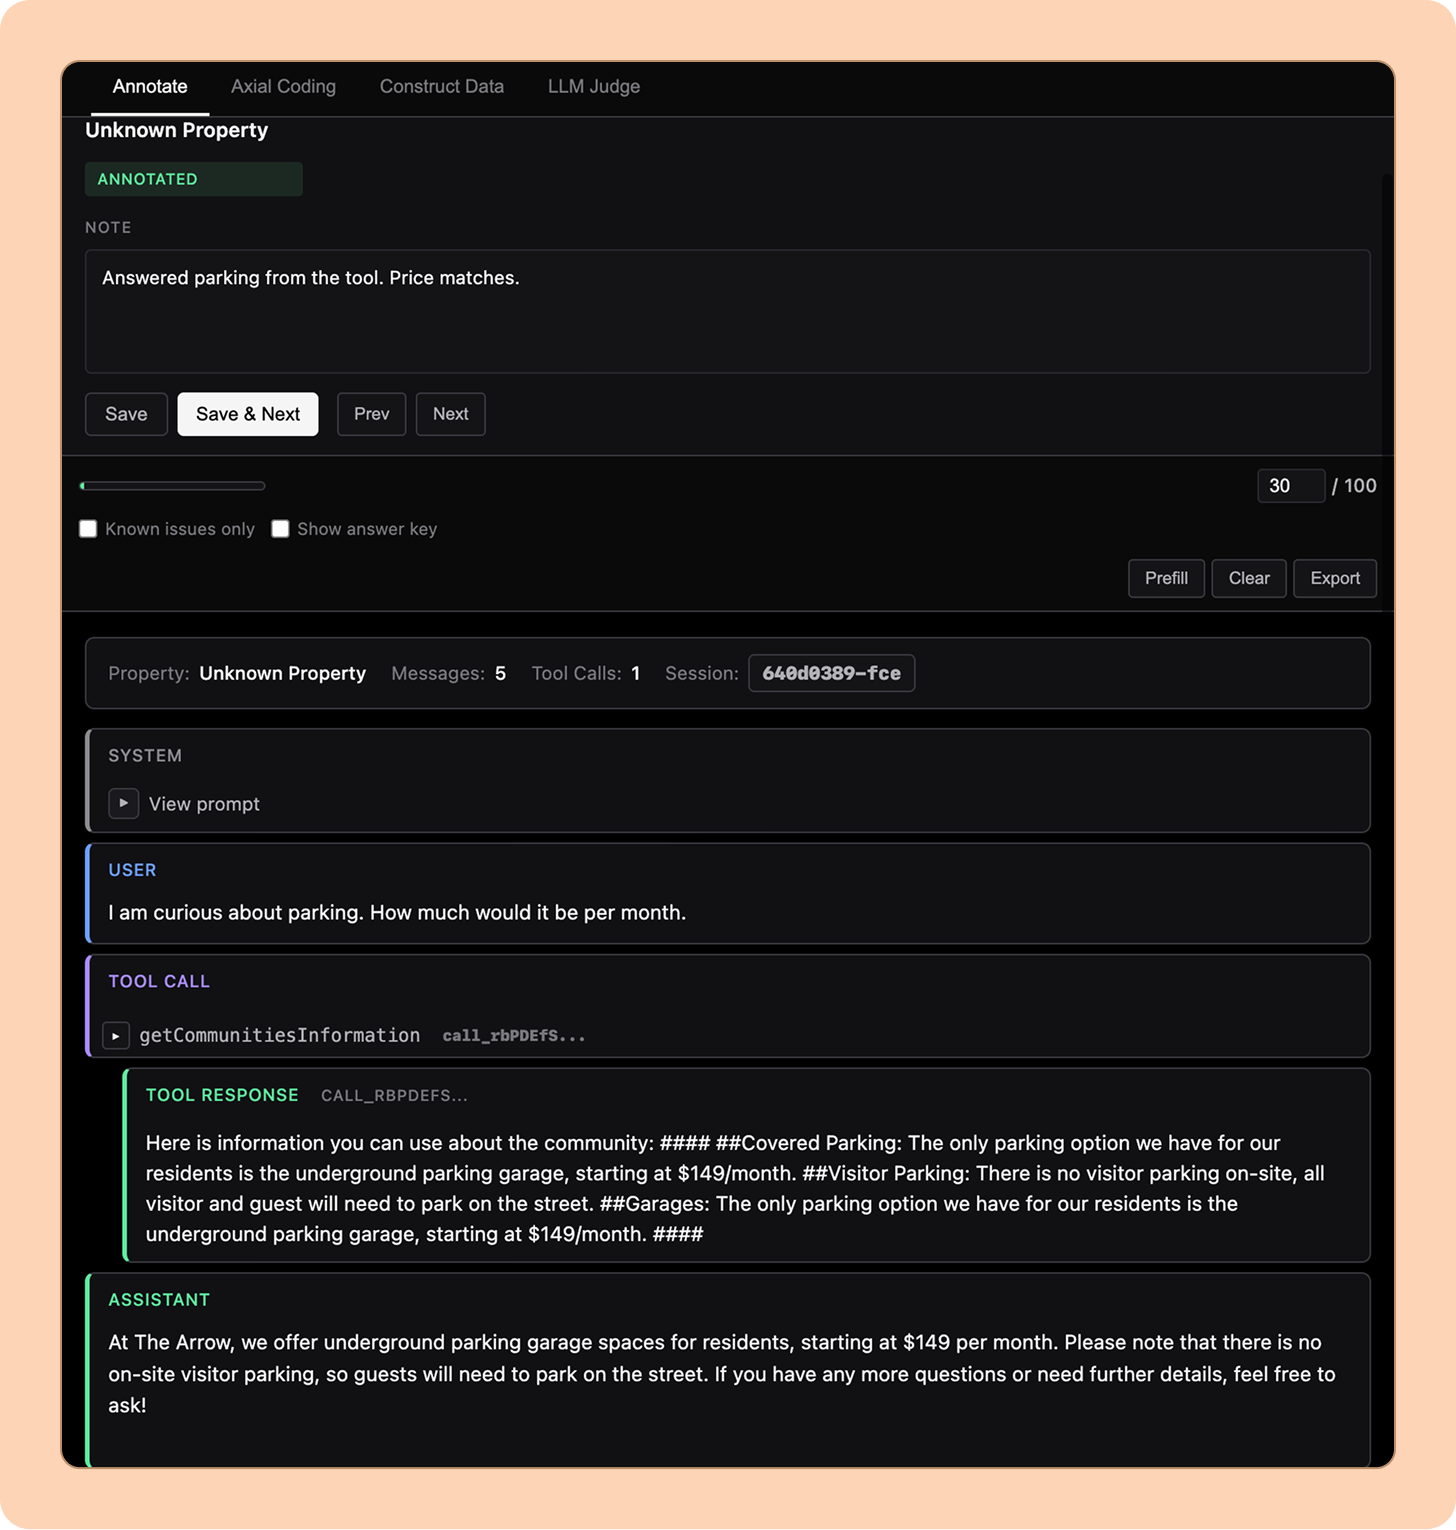
Cette interface rend la conversation comme un thread de message, avec des appels d’outils et leurs sorties affichées à côté. Vous entrez vos annotations dans une zone de texte en format libre.
La personnalisation de l’interface est une partie importante de la valeur du plugin. Différents types d’interfaces sont les mieux adaptés pour examiner différents types de données. Par exemple, voici à quoi l’interface d’annotation rendue pourrait ressembler pour un assistant d’écriture :
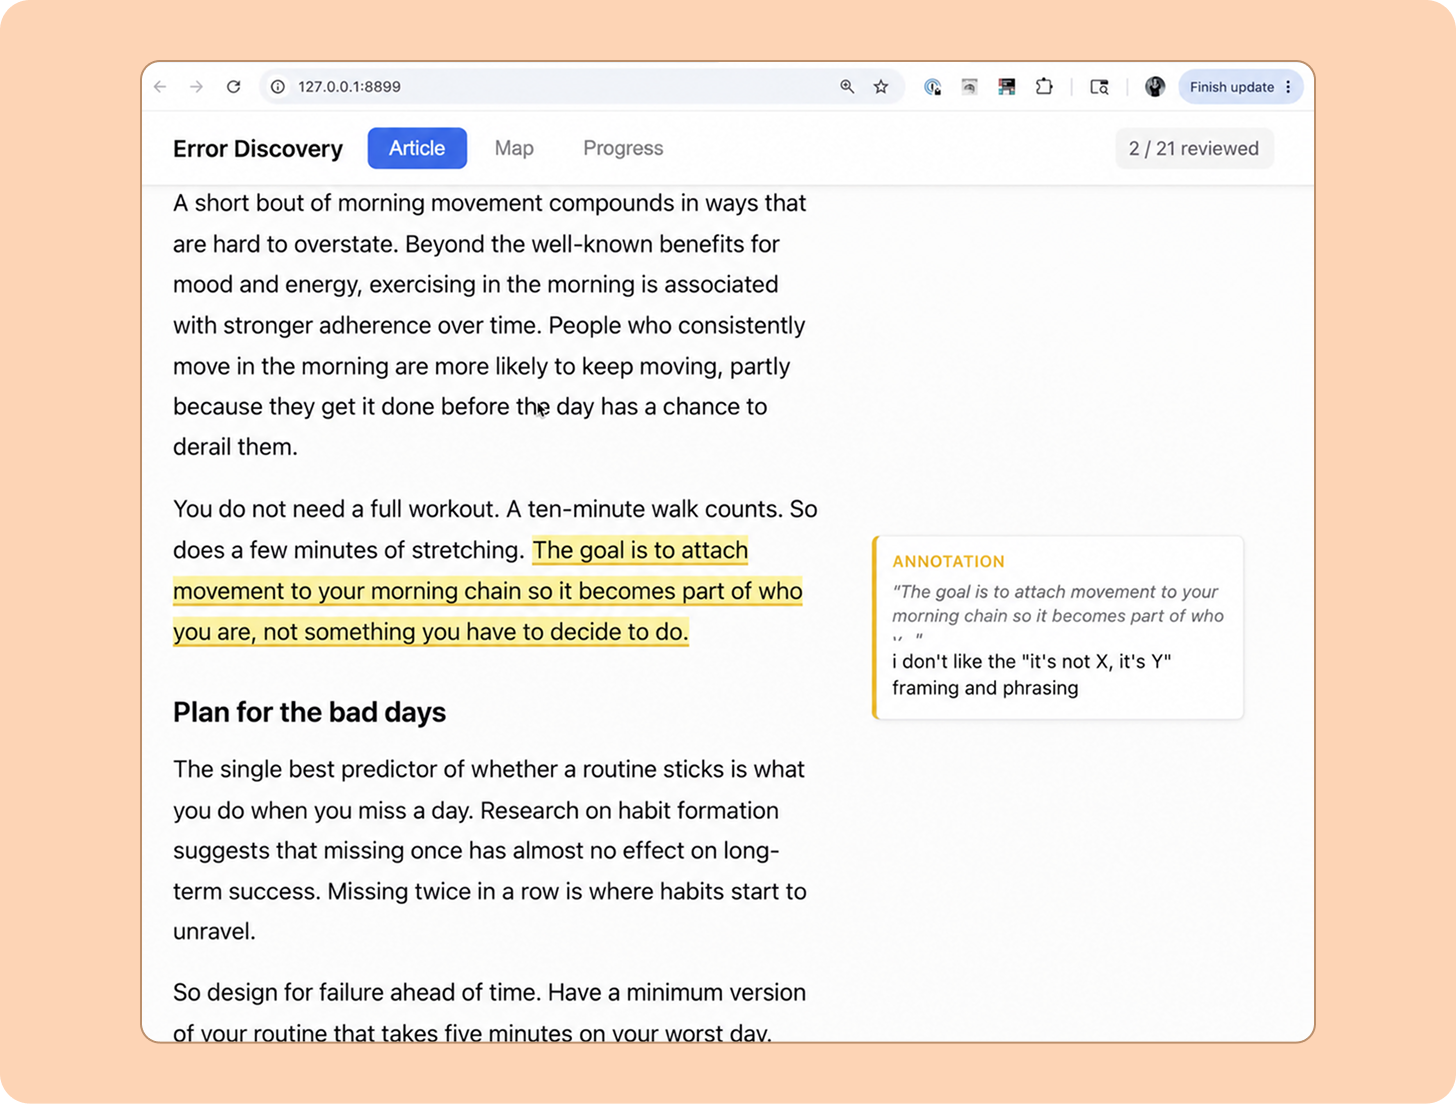
Dans cette application, l’écriture s’affiche comme un bloc de texte, avec des drapeaux affichés à côté, ce qui le rend bien adapté à la révision de l’écriture.
Plusieurs principes de conception sont intégrés dans la compétence qui guide la façon dont une interface va rendre. Les deux plus importants sont les suivants :
-
Affiche la sortie orientée vers l’utilisateur de la manière dont l’utilisateur la voit. Par exemple, un courriel doit ressembler à un courriel, un PDF doit être rendu en format PDF, etc.
-
Expliquez les métadonnées importantes qui peuvent être utiles pour la navigation ou le filtrage. Dans l’exemple de location, le canal que l’utilisateur passe est probablement important et mérite d’être filtré sur: SMS, voix, chat web, etc.
La compétence enseigne également à votre agent de regrouper vos traces afin qu’il puisse construire un échantillon initial diversifié. Il mélange les représentants des grappes avec les sélections aléatoires. Cette approche n’est pas parfaite, mais nous avons trouvé qu’elle était un meilleur point de départ que des approches naïves pour examiner les données. Voici un exemple de la façon dont votre agent de codage pourrait faire surface des clusters pour votre examen avec l’assistant d’écriture:
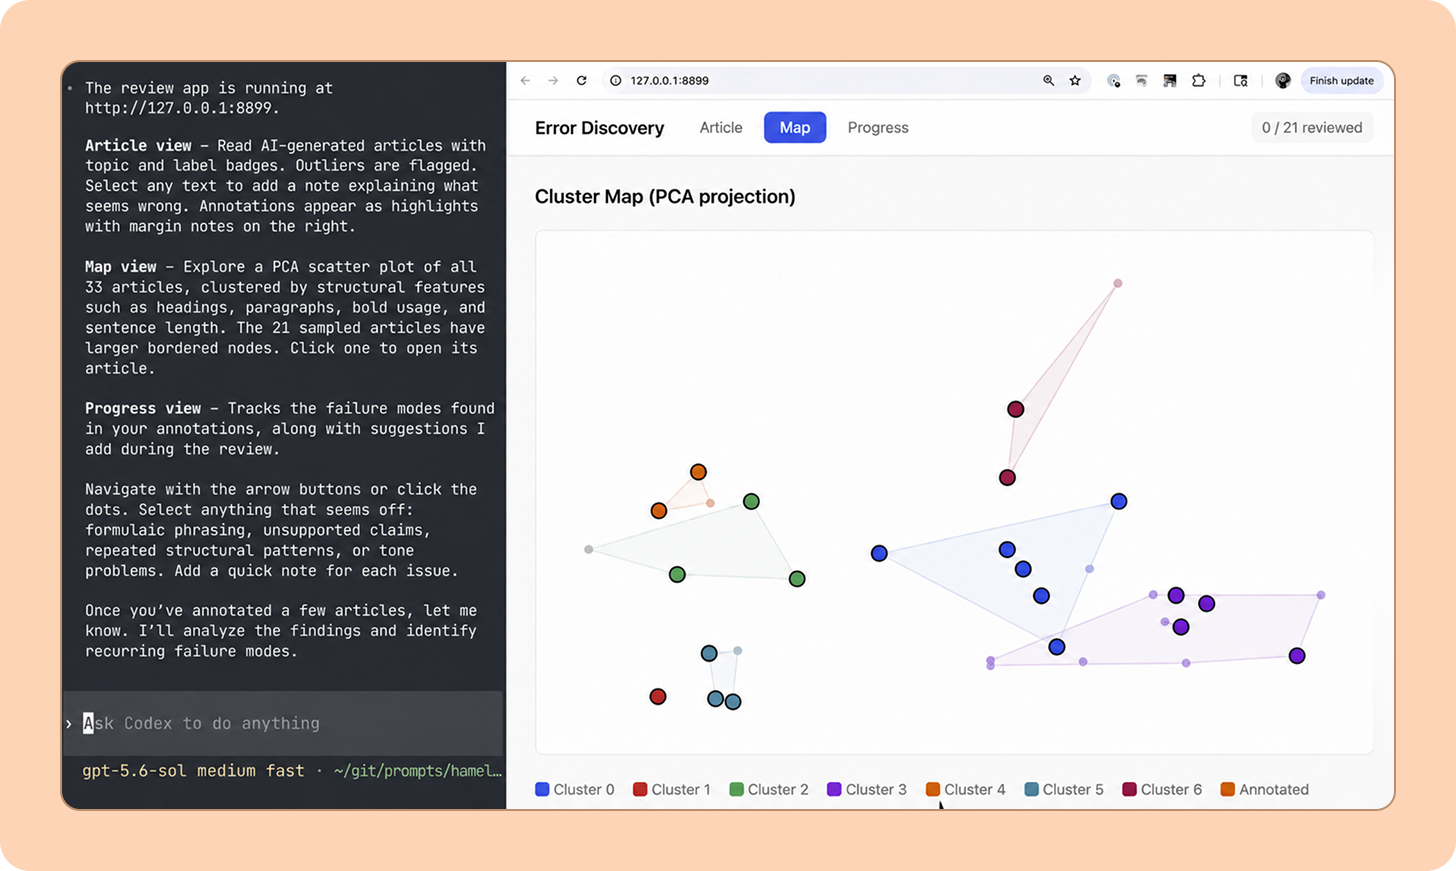
Dans l’exemple ci-dessus, l’application d’annotation de l’assistant d’écriture vous permet de survoler les groupes pour examiner les documents représentatifs. Si vous devez apporter des modifications aux clusters, à l’interface ou à tout autre élément, vous pouvez simplement discuter avec l’IA.
Le plus grand avantage de l’utilisation d’un agent de codage est la capacité de changer l’interface à la volée. Si vous remarquez un champ manquant, voulez filtrer une tranche de traces, ou rendre les données différemment, tout ce que vous avez à faire est de demander. Par exemple, si vous avez généré des traces synthétiques comme décrit dans la dernière section, vous pouvez demander à votre agent de codage de créer des filtres en fonction des dimensions définies comme persona ou type de tâche. Cela vous permet de vérifier si un échec est concentré dans un genre de scénario.
Une fois l’application en cours d’exécution, la compétence vous demande de revoir 10 traces avant qu’elle ne suggère des erreurs à revoir. Il s’agit d’une protection délibérée contre les biais d’automatisation. Votre tâche est de laisser une note en texte libre sur tout ce qui vous dérange. Les annotations pourraient ressembler à : -L’assistant a abandonné au lieu d’offrir des alternatives. – Impossible de rendre un widget de programmation et fourni une liste des heures à la place. -Le ton est trop formel pour cette persona.
Quelques règles pour faire des annotations:
-
Décrivez le problème pour qu’un collègue (ou un agent) puisse comprendre ce que vous entendiez par là. -La mauvaise réponse est une mauvaise annotation. -L’assistant a dit que l’unité était disponible lorsque la sortie de l’outil a montré qu’elle était louée.
-
Ne tentez pas de faire l’analyse de la cause racine. Vous cherchez ce qui a mal tourné du point de vue de l’utilisateur, pas pourquoi votre système a échoué en interne. Par exemple, ne pas essayer de diagnostiquer les problèmes de récupération.
-
Arrêtez à la première erreur en amont. Si une trace a plusieurs problèmes, annotez la première que vous remarquez. Cette heuristique vous aide à gagner du temps et à vous concentrer sur les problèmes les plus importants, car les défaillances en amont des trajectoires d’agents ont tendance à être plus importantes que celles en aval. Vous pouvez détendre cette contrainte plus tard lorsque vous êtes plus efficace à cet exercice.
-
Vous n’avez besoin d’annoter les échecs que lorsque vous commencez. Annoter ce qui rend une trace bonne pourrait améliorer votre compréhension de l’agent, mais peut être ignoré si vous êtes court dans le temps.
Après avoir annoté au moins 10 traces, l’IA va apprendre de vos notes initiales et essayer de trouver des problèmes supplémentaires dans vos données que vous pouvez accepter ou rejeter. Il est important de ne pas accepter aveuglément les propositions de l’agent. Examinez-les attentivement et utilisez des désaccords pour corriger la compréhension de travail de l’agent. Vous aurez peut-être besoin de plusieurs itérations humaines avant que les suggestions deviennent utiles. Nous vous encourageons à continuer à annoter au-delà des 10 premières traces jusqu’à ce que votre propre apprentissage ait été stabilisé. En règle générale, visez 100 traces pour vous assurer que vous n’êtes pas en train de quitter trop tôt. D’autres traces donneront également plus de signal à l’IA et amélioreront ses suggestions.
Voici à quoi l’interface pourrait ressembler en examinant les suggestions pour l’assistant d’écriture (votre interface spécifique sera différente, puisque l’IA le personnalise pour votre cas d’utilisation):
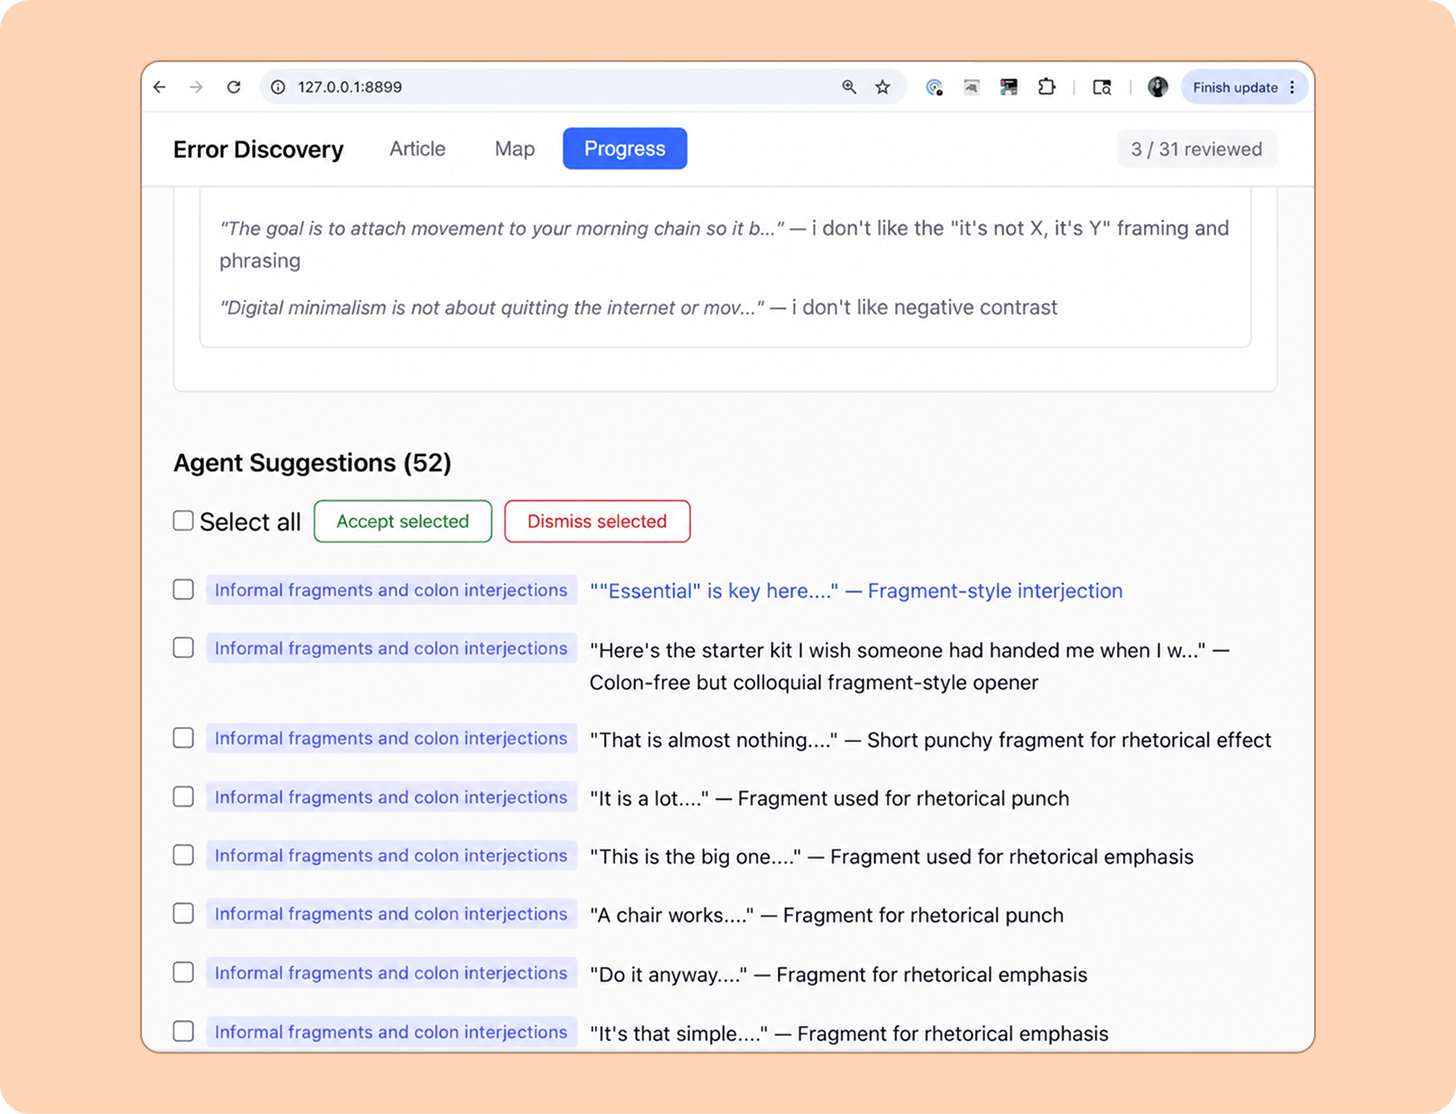
Voici une autre vision qui regroupe les suggestions par mode de défaillance:
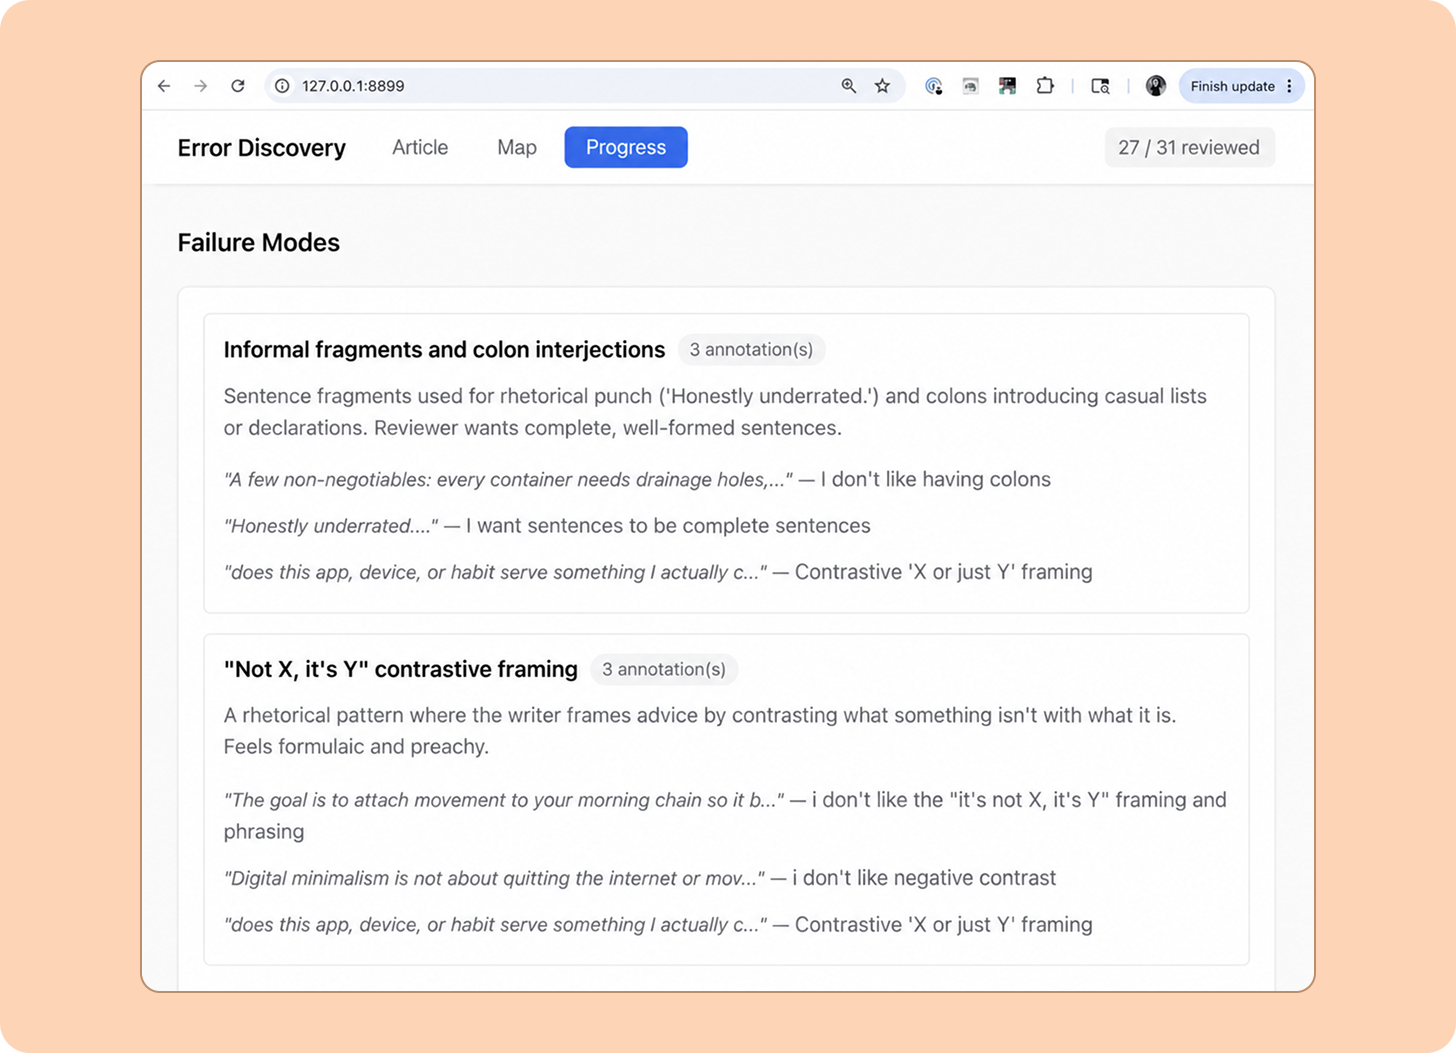
Si les suggestions AI , vous pouvez dire à votre agent de codage de le corriger, comme vous le pouvez si vous voulez changer l’interface. Vos annotations ne doivent pas être parfaites. L’objectif est de trouver des problèmes pouvant être résolus dans vos journaux plutôt que d’effectuer une recherche exhaustive. Maintenant que vous avez mis en place la base avec l’annotation hybride humaine et l’IA de vos traces, vous êtes prêt à trouver des modèles d’échec que vous pouvez agir.
Une fois que vous aurez recueilli au moins 100 traces diverses annotées, votre prochaine tâche sera de les transformer en une liste de questions prioritaires de produits. L’IA tentera de regrouper vos annotations en modes d’échec et de les compter pour que vous puissiez repérer les modèles. Voici à quoi ressemble notre assistante de location d’appartements :